Dual N-Back · गाइड
Dual N-Back: स्कोर, सूत्र और कैलकुलेटर
dual n-back में हिट, मिस और झूठे अलार्म को समझें। एक कार्यान्वित उदाहरण और एक इंटरैक्टिव कैलकुलेटर के साथ स्कोरिंग फ़ार्मुलों की तुलना करें।
इस गाइड में12
एक स्ट्रीम और एक तुलना नियम से शुरुआत करें
डुअल n-back आपको स्थिति और ध्वनि को अलग-अलग आंकने के लिए कहता है। प्रत्येक स्ट्रीम के लिए, लक्ष्य एक ऐसा आइटम है जो उस आइटम से बिल्कुल मेल खाता है जो एन पहले मुड़ता है। प्रतिक्रिया प्रतिक्रिया विंडो के भीतर संबंधित नियंत्रण पर एक प्रेस है। एक ही मोड़ में एक लक्ष्य एक धारा में, दोनों में, या किसी में भी नहीं हो सकता है। प्रतिशत की व्याख्या करने से पहले, यह स्थापित करें कि यह कौन सी स्ट्रीम, कौन से योग्य मोड़ और कौन सी प्रतिक्रिया विंडो का वर्णन करता है। गणना नियम के बिना एक प्रतिशत वह जानकारी छोड़ देता है जिसकी आपको व्याख्या करने के लिए आवश्यकता होती है।
चार संभावित परिणाम
हिट का मतलब है कि आपने वास्तविक मैच के लिए दबाव डाला है। मिस का मतलब है कि एक वास्तविक मैच आवश्यक प्रतिक्रिया के बिना पारित हो गया। गलत अलार्म का मतलब है कि आपने तब दबाया जब आवश्यक दूरी पर कोई मिलान नहीं था। सही अस्वीकृति का मतलब है कि कोई मेल नहीं था और आपने दबाव नहीं डाला। ये चार गणनाएँ एक स्ट्रीम में योग्य तुलनाओं के लिए एक संपूर्ण रिकॉर्ड बनाती हैं। वे परिणामों का वर्णन करते हैं, उनके कारणों का नहीं: एक झूठे अलार्म में एन के बारे में भ्रम, एक आकस्मिक टैप या अनिश्चित निर्णय शामिल हो सकता है। अकेले गिनती आपको नहीं बता सकती कि क्या हुआ।
एक कारगर उदाहरण: 100 योग्य तुलनाएँ
20 मिलानों और 80 गैर-मिलानों वाली एक स्ट्रीम की कल्पना करें। आप 16 मिलानों की सही पहचान करते हैं, 4 चूक जाते हैं, 8 गैर-मिलानों पर गलत तरीके से दबाते हैं और 72 गैर-मिलानों को सही ढंग से छोड़ देते हैं। चार गिनती का योग 100 होता है: 16 + 4 + 8 + 72। ये आविष्कृत शिक्षण मूल्य हैं, न कि उपयोगकर्ताओं या किसी अनुशंसित लक्ष्य के परिणाम। एक संपूर्ण उदाहरण रखने से यह देखना आसान हो जाता है कि कैसे एक ही प्रदर्शन बिना किसी गणना के अंकगणितीय रूप से गलत हुए विभिन्न प्रतिशत उत्पन्न कर सकता है।
100 तुलनाएँ, चार संभावित परिणाम
- सही पहचाने गए लक्ष्य 16
- छूटे हुए लक्ष्य 4
- गलत अलार्म 8
- सही अस्वीकृतियाँ 72
हिट दर और झूठी-अलार्म दर अलग-अलग भाजक का उपयोग करती हैं
हिट दर: सही पहचाने गए लक्ष्य / (सही पहचाने गए लक्ष्य + छूटे हुए लक्ष्य) = 16 / (16 + 4) = 80 %. गलत-अलार्म दर: गलत अलार्म / (गलत अलार्म + सही अस्वीकृतियाँ) = 8 / (8 + 72) = 10 %. यदि हर शून्य है, तो दर अपरिभाषित है। सूत्र और पूरा उदाहरण जावास्क्रिप्ट के बिना भी पठनीय रहते हैं।
समग्र सटीकता और सक्रिय सटीकता विभिन्न प्रश्नों का उत्तर देती है
समग्र सटीकता: (सही पहचाने गए लक्ष्य + सही अस्वीकृतियाँ) / (सही पहचाने गए लक्ष्य + छूटे हुए लक्ष्य + गलत अलार्म + सही अस्वीकृतियाँ) = (16 + 72) / 100 = 88 %. सक्रिय सटीकता: सही पहचाने गए लक्ष्य / (सही पहचाने गए लक्ष्य + छूटे हुए लक्ष्य + गलत अलार्म) = 16 / (16 + 4 + 8) ≈ 57.1 %. Precision (PPV): सही पहचाने गए लक्ष्य / (सही पहचाने गए लक्ष्य + गलत अलार्म) = 16 / (16 + 8) ≈ 66.7 %.
कभी भी दबाना भ्रामक रूप से अच्छा क्यों नहीं लग सकता
उदाहरण के लिए 20 मिलान और 80 गैर-मिलान रखें, लेकिन कल्पना करें कि कभी दबाव न डालें। गिनती 0 हिट, 20 मिस, 0 गलत अलार्म और 80 सही अस्वीकृति हो जाती है। कुल मिलाकर सटीकता 80% है, भले ही प्रत्येक मैच छूट गया हो। सक्रिय सटीकता 0% है, हिट दर 0% है और झूठी-अलार्म दर 0% है। उदाहरण हर के महत्व को दर्शाता है; इसका मतलब यह नहीं है कि कोई ऐप कुछ न करने पर 80% पुरस्कार देता है। एक लक्ष्य-संवेदनशील स्कोरिंग नियम एक ही व्यवहार को काफी अलग तरीके से व्यवहार कर सकता है।
गिनती को ऐप परिणाम से भ्रमित किए बिना आज़माएं
नीचे दिया गया कैलकुलेटर एक स्ट्रीम पर काम करता है। इसके शुरुआती मान 100-तुलना उदाहरण को पुन: पेश करते हैं। चार सूत्रों का पता लगाने के लिए गिनती बदलें, या प्रतिक्रिया पैटर्न बदलते समय लक्ष्यों की संख्या स्थिर रखने के लिए कभी न दबाए गए उदाहरण का उपयोग करें। शून्य-भाजक परिणामों को चुपचाप अच्छे या बुरे स्कोर में परिवर्तित करने के बजाय अपरिभाषित के रूप में दिखाया जाता है। यह एक शिक्षण उपकरण है, न कि आपके ऐप इतिहास का आयात, प्रत्येक ऐप संस्करण का पुनर्निर्माण या नैदानिक मूल्यांकन। मान आपके ब्राउज़र में रहते हैं.
स्कोरिंग फ़ॉर्मूले का अन्वेषण करें
एक स्ट्रीम · काल्पनिक उदाहरण · कोई डेटा नहीं भेजा गया
यदि हर शून्य है, तो दर अपरिभाषित है। सूत्र और पूरा उदाहरण जावास्क्रिप्ट के बिना भी पठनीय रहते हैं।
उन्हें संयोजित करने से पहले स्थिति और ध्वनि पढ़ें
अंतर्निहित गणना उपलब्ध होने पर प्रत्येक स्ट्रीम की अलग से गणना करें। यदि आप धाराओं को जोड़ते हैं, तो तय करें कि आप गिनती पूल कर रहे हैं या प्रतिशत औसत कर रहे हैं। जब हर भिन्न होते हैं तो वे प्रक्रियाएँ भिन्न हो सकती हैं। उदाहरण के लिए, 10 लक्ष्य परीक्षणों में 9 हिट वाली एक धारा में 90% हिट दर होती है, जबकि 2 लक्ष्य परीक्षणों में 1 हिट वाली दूसरी धारा में 50% हिट दर होती है। उनका साधारण औसत 70% है; उनकी एकत्रित हिट दर 10/12 है, लगभग 83.3%। रिपोर्ट करें कि आपने किस गणना का उपयोग किया। किसी को भी चुपचाप दूसरे के स्थान पर प्रतिस्थापित नहीं किया जाना चाहिए।
एक अच्छा स्कोर कार्य सेटिंग्स पर निर्भर करता है
एन, सक्रिय धाराओं की संख्या, गति, योग्य परीक्षणों की संख्या, लक्ष्य आवृत्ति और स्कोरिंग फॉर्मूला सभी स्कोर के अर्थ को प्रभावित करते हैं। किसी भिन्न सेटअप का परिणाम स्वचालित रूप से आपसे बेहतर या ख़राब नहीं होता है। जांचें कि पर्याप्त इतिहास के बिना प्रारंभिक मोड़ों का इलाज कैसे किया जाता है, क्या एक साथ मिलानों के लिए दो प्रतिक्रियाओं की आवश्यकता होती है और क्या छूटी हुई प्रतिक्रियाओं को स्ट्रीम द्वारा अलग से गिना जाता है। समय के साथ तुलना के लिए, उन सेटिंग्स को व्यावहारिक रूप से सुसंगत रखें और प्रत्येक प्रतिशत को विनिमेय मानने के बजाय परिवर्तनों को रिकॉर्ड करें।
स्कोर की तुलना करने से पहले सेटिंग्स पढ़ें
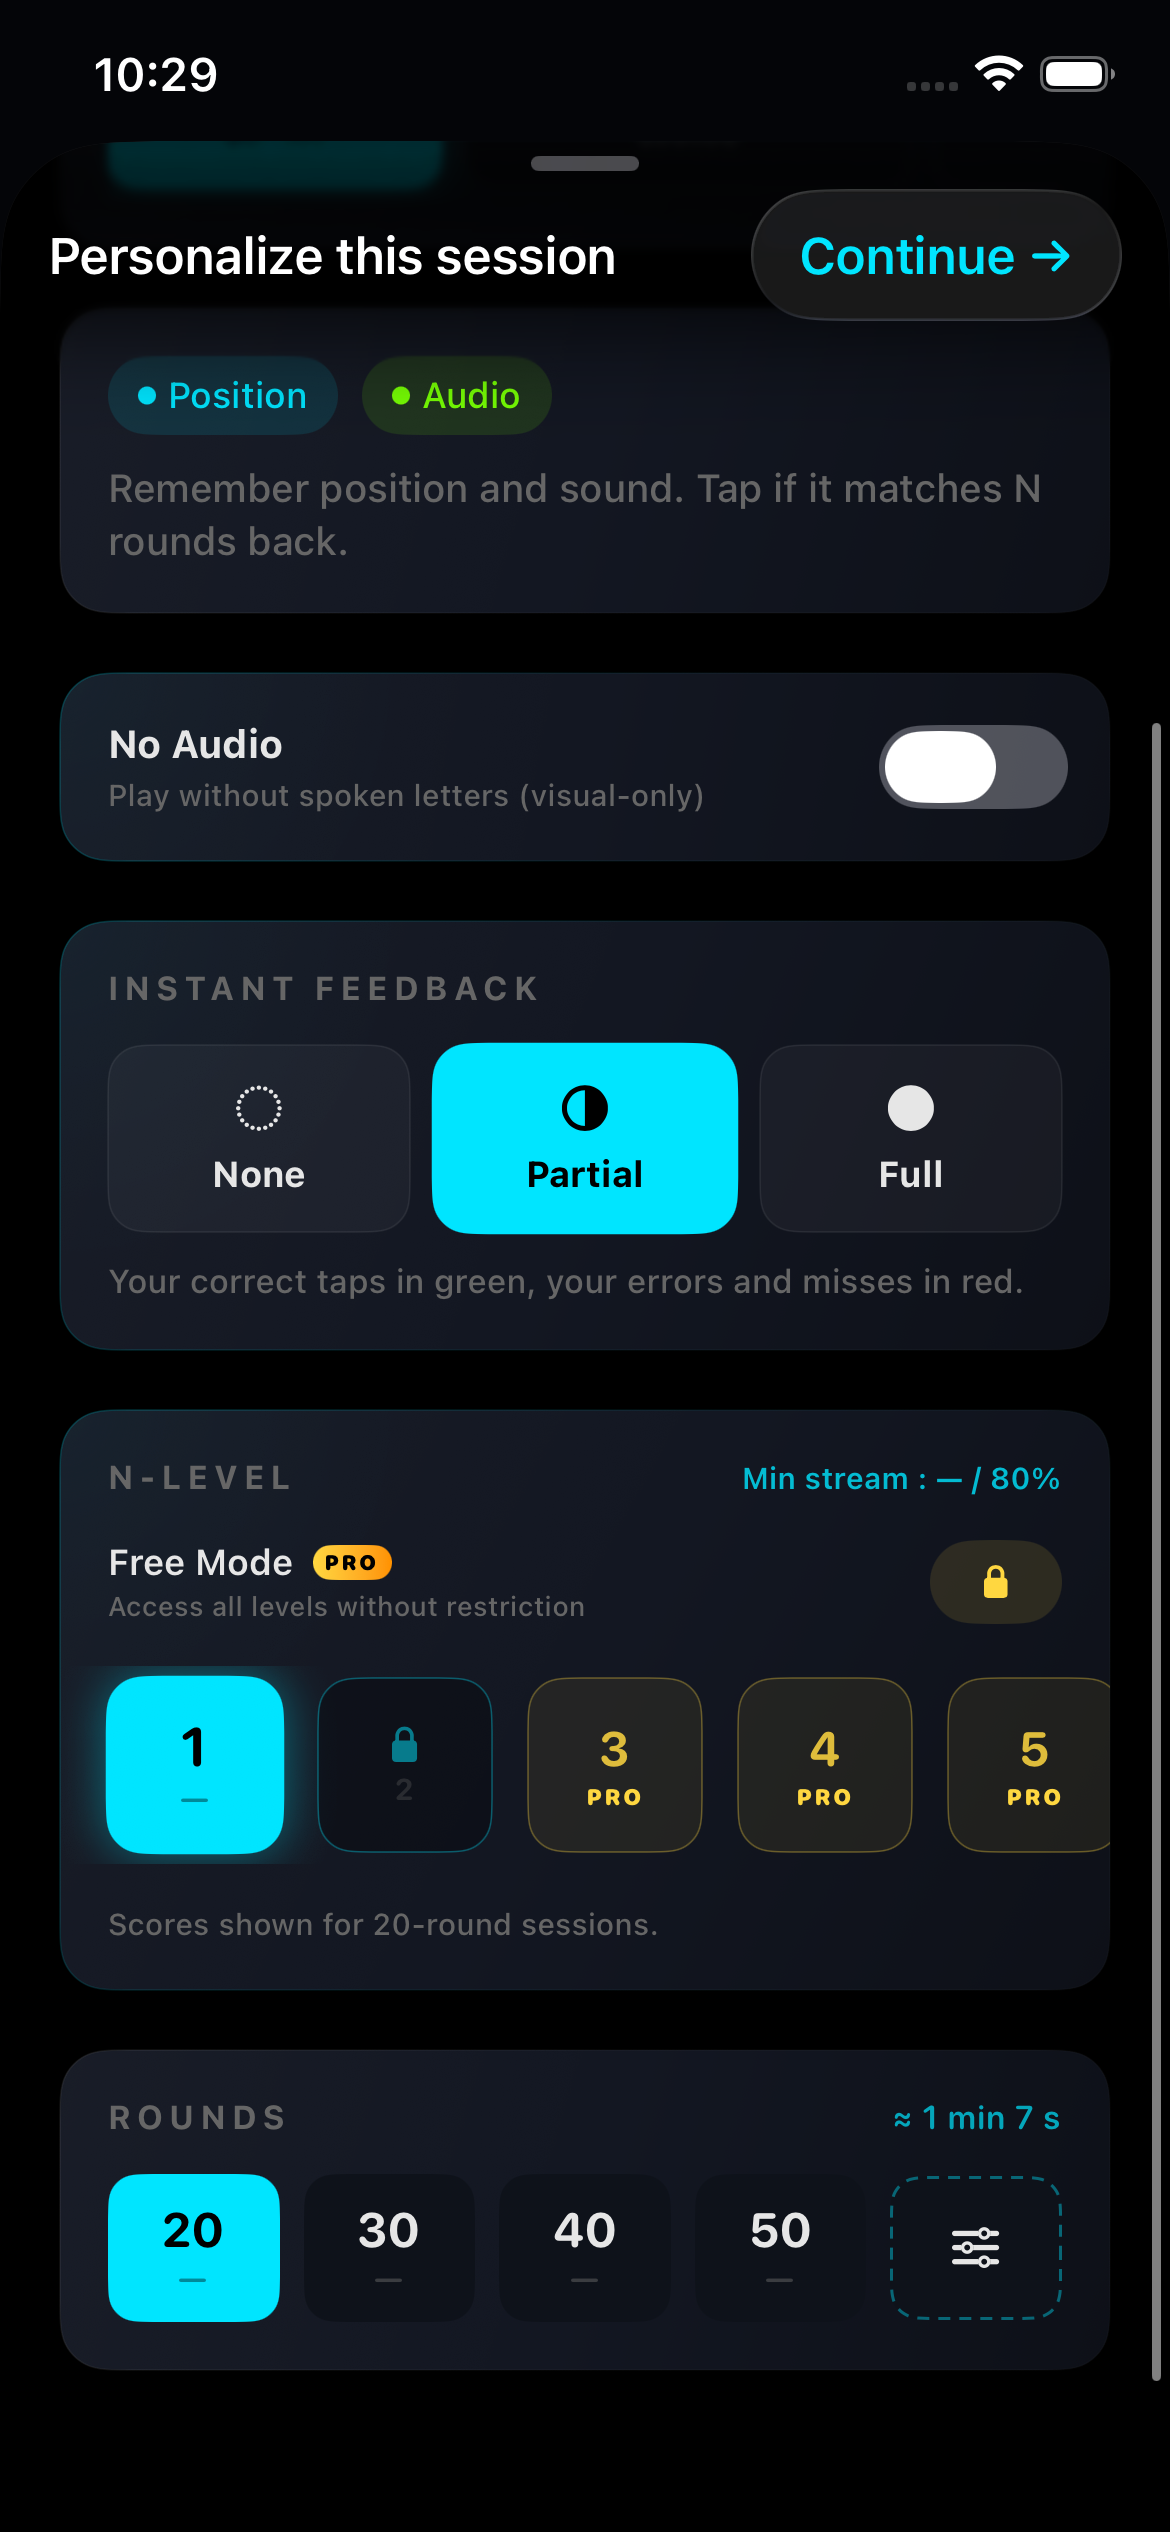
वास्तविक ऐप कैप्चर · सितंबर 2026 · इंटरफ़ेस भाषा भिन्न हो सकती है · EN · 2026-09-06
परिवर्तनशीलता जानकारी है, निदान नहीं
एक सत्र ध्यान, नियंत्रणों से परिचित होने, रुकावटों या अन्य स्थितियों के आधार पर भिन्न हो सकता है। केवल एक स्कोर यह स्थापित नहीं करता है कि यह क्यों बदला है, और यहां नींद, कैफीन या किसी विशेष दिन के लिए एक निश्चित प्रभाव निर्दिष्ट करने का कोई आधार नहीं है। किसी प्रवृत्ति की व्याख्या करने से पहले कई तुलनीय सत्र देखें। एक पठार एक जैविक छत की पहचान नहीं करता है, और कम परिणाम अपने आप में सामान्य स्मृति क्षमता का नुकसान नहीं दर्शाता है। यदि कोई सत्र असहज या निराशाजनक लगता है, तो गारंटीकृत स्कोरिंग रणनीति के बजाय एक छोटा सत्र या ब्रेक एक व्यावहारिक विकल्प है।
एक साधारण अभ्यास रिकॉर्ड में क्या रखना चाहिए?
दिनांक, एन, सक्रिय स्ट्रीम, गति, योग्य परीक्षण गणना और प्रयुक्त सूत्र रखें। उपलब्ध होने पर, प्रत्येक स्ट्रीम के लिए चार परिणाम गणनाएँ रखें; फिर दरों की उनके हर का अनुमान लगाए बिना पुनर्गणना की जा सकती है। यदि इससे आपको बाद में सत्र की व्याख्या करने में मदद मिलेगी तो किसी रुकावट या सेटिंग्स में बदलाव के बारे में एक संक्षिप्त नोट जोड़ें। एक व्यक्तिगत सर्वश्रेष्ठ प्रेरक हो सकता है, लेकिन यह एक सामान्य परिणाम के समान नहीं है। कुछ तुलनीय रिकॉर्ड कार्य के विवरण के बिना प्रतिशत के संग्रह की तुलना में अधिक जानकारीपूर्ण हैं।
ट्रैक dual n-back प्रगति: एक व्यावहारिक सत्र लॉगये संख्याएँ क्या स्थापित कर सकती हैं और क्या नहीं
ये स्कोर विशेष नियमों के तहत किसी विशेष कार्य की प्रतिक्रियाओं का वर्णन करते हैं। उस कार्य में सुधार, अपने आप में, आईक्यू में मापी गई वृद्धि या स्कूल या काम में बेहतर प्रदर्शन का प्रमाण नहीं है। शोध मार्गदर्शिका अभ्यास लाभ और अन्य परिणामों में स्थानांतरण के बीच अंतर बताती है। अपनी प्रतिक्रियाओं और अभ्यास के नियमों को समझने के लिए स्कोर का उपयोग करें। अपने वास्तविक सत्र परिणाम के लिए, ऐप द्वारा दिखाई गई परिभाषाएँ और प्रति-स्ट्रीम ब्रेकडाउन देखें; अंकगणित को पारदर्शी बनाने के लिए कैलकुलेटर मौजूद है।
क्या Dual N-Back प्रभावी है? शोध और सीमाएँसवाल
n-back में गलत अलार्म क्या है?
एक प्रतिक्रिया जब आवश्यक N-back दूरी पर कोई मिलान नहीं था। यह एक परिणाम का वर्णन करता है; अकेले गिनती से यह स्थापित नहीं होता है कि इसका कारण अनुमान लगाना, भ्रम या आकस्मिक टैप था।
एक ही सत्र 88% और 57.1% क्यों दिखा सकता है?
सूत्र विभिन्न हरों का उपयोग कर सकते हैं। काम किए गए उदाहरण में, समग्र सटीकता (16 + 72) / 100 = 88% है, जबकि सक्रिय सटीकता 16 / (16 + 4 + 8) है, लगभग 57.1%।
क्या कैलकुलेटर मेरे ऐप स्कोर को पुन: प्रस्तुत करता है?
यह एक धारा के लिए चार स्पष्ट सूत्रों को दर्शाता है। आपका प्रदर्शित ऐप परिणाम विभिन्न पात्रता नियमों का उपयोग कर सकता है या कई धाराओं को जोड़ सकता है। तुलना करने से पहले ऐप की परिभाषाएँ जांचें।
क्या होता है जब हर शून्य होता है?
वह दर अपरिभाषित है. कैलकुलेटर छूटे हुए अवलोकनों को पूर्ण या असफल प्रदर्शन मानने के बजाय एक अपरिभाषित परिणाम प्रदर्शित करता है।
और पढ़ें
- Kane et al. (2007), Working memory, attention control, and the n-back task, Journal of Experimental Psychology: Learning, Memory, and Cognition
- Cowan (2010), The Magical Mystery Four: How is working memory capacity limited, and why?, Current Directions in Psychological Science
- scikit-learn documentation — classification metrics and confusion matrices (mathematical definitions)
गाइड
dual n-back कैसे खेलें: एक स्पष्ट पहला सत्र
अपने पहले dual n-back सत्र से पहले स्थिति मिलान, ध्वनि मिलान और N का अर्थ समझें।
प्रतिक्रिया समय और स्ट्रूप परीक्षण: ये कार्य वास्तव में क्या मापते हैं
एक प्रतिक्रिया-समय कार्य स्ट्रूप कार्य से कैसे भिन्न होता है, प्रत्येक में क्या लोड होता है, आपके स्कोर इतने अधिक क्यों बदलते हैं, और स्वयं को मूर्ख बनाए बिना परिणामों की तुलना कैसे करें।
dual n-back को कितनी देर तक और कितनी बार प्रशिक्षित करना है: अध्ययनों ने वास्तव में क्या किया
dual n-back अनुसंधान में उपयोग की जाने वाली सत्र की लंबाई और आवृत्तियाँ, स्थानांतरण के बारे में साक्ष्य क्या दिखाते हैं, और यथार्थवादी अपेक्षाएँ कैसे निर्धारित करें।
कार्यशील स्मृति क्या है और कैसे काम करती है?
कार्यशील मेमोरी का विचार कहां से आता है, शोधकर्ता इसे कैसे मापते हैं, इसकी क्षमता सीमित क्यों है, और n-back कार्य वास्तव में इससे क्या पूछता है।
क्या Dual N-Back प्रभावी है? शोध और सीमाएँ
dual n-back पर शोध के माध्यम से एक ईमानदार यात्रा: क्या सुधार होता है, क्या नहीं, मेटा-विश्लेषण असहमत क्यों होते हैं, और खुद को मूर्ख बनाए बिना कैसे प्रशिक्षित किया जाए।
N-back स्तरों की व्याख्या: N=1, N=2, N=3 और उससे आगे
समझें कि प्रत्येक n-back स्तर पर क्या परिवर्तन होता है, स्थिति और ध्वनि की सही तुलना करें, और मनमाने लक्ष्य के बजाय सटीकता का उपयोग करके कठिनाई चुनें।
दस dual n-back गलतियाँ जो चुपचाप आपकी प्रगति को रोक देती हैं
वे आदतें जो dual n-back स्कोर को उनके मुकाबले बेहतर बनाती हैं, अनुमान लगाने और स्तर का पीछा करने से लेकर थके हुए प्रशिक्षण तक, और इसके बजाय क्या करना है।
मस्तिष्क-प्रशिक्षण अभ्यासों की तुलना: प्रत्येक वास्तव में क्या मापता है
दोहरी n-back, अंक अवधि, जटिल अवधि, स्ट्रूप, प्रतिक्रिया समय और वाणिज्यिक मस्तिष्क-प्रशिक्षण सूट, प्रत्येक क्या मांग करता है, और प्रत्येक के लिए साक्ष्य क्या समर्थन करता है।
सिंगल बनाम dual n-back: क्या परिवर्तन होता है और कहां से शुरू करें
एकल और dual n-back की तुलना एक कार्यशील 2-back उदाहरण से करें। स्ट्रीम, कठिनाई और आपके परिणाम वास्तव में आपको क्या बता सकते हैं, इसे समझें।
ट्रैक dual n-back प्रगति: एक व्यावहारिक सत्र लॉग
स्तरों, सटीकता और त्रुटियों की निष्पक्ष तुलना करने के लिए एक सरल dual n-back सत्र लॉग का उपयोग करें। इसमें एक काल्पनिक कार्य उदाहरण और एक साप्ताहिक समीक्षा पद्धति शामिल है।
IQ कैसे बढ़ाएं? शोध और dual n-back
क्या IQ बढ़ सकता है? शिक्षा, दोबारा टेस्ट देने के प्रभाव और dual n-back की सीमाएं समझें। iPhone पर अभ्यास शुरू करने का तरीका जानें।
चिंप स्मृति परीक्षण: नियम, उदाहरण और स्कोर
चिम्प स्मृति परीक्षण को समझें, क्रमांकित स्थितियों को याद रखने का अभ्यास करें और अंकों की निष्पक्षता से तुलना करें। iPhone के लिए Dual N-Back में मेमोरी अभ्यास की खोज करें।
दृश्य स्मृति और क्रम की स्मृति: क्या अंतर है?
एक पैटर्न, एक क्रमबद्ध अनुक्रम और एक क्रमांकित लेआउट को याद रखने के बीच अंतर जानें। सरल उदाहरण आपको iPhone पर मेमोरी व्यायाम चुनने में मदद करते हैं।
पढ़ा हुआ कैसे याद रखें: सक्रिय स्मरण और अंतराल पर दोहराव
याद से उत्तर दें, गलतियाँ सुधारें और अंतराल पर दोहराएँ। पढ़ाई का एक उदाहरण और dual n-back से उसका अंतर समझें।
iPhone पर dual n-back में आवाज़ नहीं आ रही? क्या जाँचें
dual n-back में अक्षर नहीं सुन सकते? iPhone मीडिया वॉल्यूम, ब्लूटूथ आउटपुट और ऐप सेटिंग्स की जांच करें, फिर यदि समस्या बनी रहती है तो उपयोगी विवरण इकट्ठा करें।
iPhone पर Dual N-Back सेटिंग्स: ऑडियो, फीडबैक और स्तर
Dual N-Back iPhone ऐप के एनोटेटेड स्क्रीनशॉट के साथ ऑडियो, फीडबैक, एन-स्तर, प्रगति लॉक और सत्र की लंबाई को समझें।
dual n-back रूटीन कैसे बनाएं, आप ईमानदारी से पढ़ सकते हैं
सेटिंग्स चुनने, सत्रों को तुलनीय रखने और एक अंक को वादे में बदले बिना त्रुटियों से सीखने का एक व्यावहारिक तरीका।
स्ट्रूप प्रभाव परीक्षण: संज्ञानात्मक नियंत्रण और असावधानी को कैसे मापा जाता है
रंग-शब्द संघर्ष प्रतिक्रिया अवरोध, चयनात्मक ध्यान और मानसिक प्रसंस्करण गति को कैसे मापता है, और iPhone पर अपने स्कोर को कैसे प्रशिक्षित करें।
प्रतिक्रिया समय प्रशिक्षण: प्रसंस्करण गति को कैसे मापें और सुधारें
मानव प्रतिक्रिया गति, दृश्य बनाम श्रवण प्रतिक्रिया समय और प्रसंस्करण गति को प्रशिक्षित करने के लिए व्यावहारिक अभ्यास का विज्ञान।
वर्किंग मेमोरी बनाम शॉर्ट-टर्म मेमोरी: मुख्य अंतर और इसे कैसे प्रशिक्षित करें
समझें कि अल्पकालिक स्मृति निष्क्रिय भंडारण क्यों है जबकि कार्यशील स्मृति सक्रिय हेरफेर है, यह तरल बुद्धि की भविष्यवाणी कैसे करती है, और संज्ञानात्मक नियंत्रण को कैसे मजबूत किया जाए।
द्रव बुद्धि और मस्तिष्क प्रशिक्षण: विज्ञान वास्तव में क्या दिखाता है
तरल तर्क, जैगी Dual N-Back अनुसंधान, निकट स्थानांतरण, और कैसे जानबूझकर अभ्यास iPhone पर हस्तक्षेप समाधान को प्रशिक्षित करता है, पर एक वस्तुनिष्ठ नज़र।